آپتایم بیانگر نسبت یا بازۀ زمانی مشخصی است که طی آن یک سرور، وبسایت یا سرویس آنلاین بدون وقفه روشن، فعال و آماده پاسخگویی به درخواستها باقی میماند. دسترسی پیوستۀ کاربران به پایگاههای داده، اپلیکیشنها و درگاههای خرید، ارتباط مستقیمی با نرخ پایداری این شاخص دارد و هرگونه اختلال در آن فعالیت تجاری را متوقف میکند. حفظ نرخ بالای آپتایم سرور، سنگبنای اصلی اعتماد مشتریان، تداوم تراکنشهای مالی و ارتقای جایگاه سئو در موتورهای جستوجو به شمار میآید که در این نوشته از وبلاگ مبین هاست به صورت کامل آن را مورد بررسی قرار میدهیم.
آپتایم چیست؟
به زبان ساده آپتایم معیاری برای سنجش مدتزمان یا نسبت درصدی است که طی آن یک سیستم، سرور، نرمافزار یا وبسایت بهصورت فعال و بدون نقص به کاربران خدماترسانی میکند. در نقطۀ مقابل آن داونتایم (Downtime) قرار دارد که بیانگر بازههای قطعی، از کار افتادگی یا اختلال در ارائه خدمات سیستم است. این شاخص در بخشهای گوناگون دنیای فناوری اطلاعات تعاریف و کاربردهای ویژهای دارد:
- آپتایم سیستم و سرور (System Uptime): زمان سپریشده از لحظۀ آخرین راهاندازی (بوت یا ریاستارت) سیستمعامل تا لحظۀ کنونی بدون وقفۀ فیزیکی.
- آپتایم سرویس و وبسایت (Service & Website Uptime): نسبت درصدی از یک بازۀ زمانی معین که در آن سایت یا سرویس وب به درخواستهای کاربران بهدرستی پاسخ میدهد.
- آپتایم شبکه و زیرساخت (Network Uptime): میزان زمان در دسترس بودن مسیرهای ارتباطی، سوییچها، روترها و پایداری تبادل دادهها در شبکه.
- آپتایم در دستگاههای همراه (Mobile Device Uptime): مدتزمان روشن ماندن پیوستۀ گوشی هوشمند یا تبلت پس از آخرین ریاستارت به عنوان معیاری از پایداری سیستمعامل.
نکتۀ مهم: هرچند این مفهوم تمام لایههای سختافزاری و نرمافزاری را پوشش میدهد، اما تمرکز اصلی ما در این مقاله، بررسی تخصصی آپتایم در لایۀ سرویسها، وبسایتها و زیرساختهای میزبانی است.
تفاوت آپتایم (Uptime) و دسترسیپذیری (Availability) چیست؟
آپتایم صرفاً روشن بودن و کارکرد فنی یک قطعه یا سرور را میسنجد، در حالی که دسترسیپذیری امکان استفادۀ بدون اختلال کاربر از کل فرایند سرویس را بررسی میکند. تکیه بر وضعیت سرور بهتنهایی پدیدهای موسوم به «اثر هندوانهای» (Watermelon Effect) ایجاد میکند؛ وضعیتی که داشبورد زیرساخت از بیرون سبز و سالم است، اما تجربۀ کاربر به علت خطاهای پنهان قرمز و همراه با قطعی است.
ابعاد کلیدی تفاوت این دو معیار آپتایم و دسترسیپذیری در جدول زیر مقایسه شده است:
| بعد مقایسه | آپتایم (Uptime) | دسترسیپذیری (Availability) |
| پرسش و تمرکز اصلی | آیا سختافزار، سرور یا مؤلفۀ روشن و در حال کار است؟ | آیا کاربر نهایی میتواند بدون مشکل از سرویس استفاده کند؟ |
| سطح و دامنۀ پایش | لایۀ سختافزار، سیستمعامل و پورتهای سرور | فرایند کامل سرویس (End-to-End)، مسیر خرید و تعامل با API |
| نحوۀ ارزیابی و سیگنالها | ارسال بستههای پینگ (ICMP) و وضعیت پروسسها | نرخ خطا (Error Rate)، زمان پاسخدهی و نرخ موفقیت تراکنشها |
| تعمیرات برنامهریزیشده | اغلب از محاسبات زمان قطعی کسر میشود | در سنجش تجربۀ کاربر به عنوان عدم دسترسی شمرده میشود |
| محدودیت اصلی در تحلیل | خطاهای منطقی و باگهای نرمافزاری را نشان نمیدهد | وابسته به تعیین دقیق سناریوهای کاربری و شاخصهای تکمیل کار است |
اکتفا به معیارهای آپتایم سرور بدون پایش دسترسیپذیری لایه وب، خطاهای سمت پایگاهداده و درگاههای پرداخت را از چشم تیم فنی پنهان نگه میدارد.
آپتایم سرور چیست و پایداری زیرساخت چگونه تضمین میشود؟
آپتایم سرور شاخصی حیاتی برای سنجش تابآوری فنی زیرساخت است که تداوم روشن بودن سختافزار، سلامت هستۀ سیستمعامل و برقراری پیوستۀ ارتباطات شبکهای ماشین را ارزیابی میکند. چند مؤلفۀ بنیادین بهطور مستقیم پایداری این لایه را رقم میزنند که از میان آنها میتوان به موارد زیر اشاره کرد:
- پایداری فیزیکی قطعات اصلی شامل منبع تغذیه، حافظه رم و دیسکها.
- سلامت و بهروزرسانی هستۀ سیستمعامل برای ممانعت از کرشهای نرمافزاری.
- اتصال پایدار پورتهای شبکه و برقراری مداوم پهنای باند بدون نوسان.
- پایش بار پردازشی ماشین برای جلوگیری از اشباع منابع سیستم.
برای حفظ تداوم کسبوکار در مقیاسهای حساس، اتکا به یک سرور مجزا کافی نیست و زیرساخت نیازمند افزونگی کامل در تمامی لایهها خواهد بود. برای آشنایی با روشهای حذف نقاط تکین خرابی و راهاندازی کلاسترهای همیشه دردسترس، مطالعه مقالۀ high availability دیدی جامع در اختیارتان میگذارد.
نحوۀ محاسبۀ آپتایم سرور و تحلیل استاندارد تعداد ۹ها (The Nines)
محاسبۀ دقیق پایداری سرور، پایهایترین گام برای ارزیابی عملکرد زیرساخت و سنجش پایبندی به تعهدات فنی است. فرمول استاندارد سنجش درصد آپتایم بر مبنای کسر کل زمان قطعی از کل زمان بازۀ پایش به دست میآید:
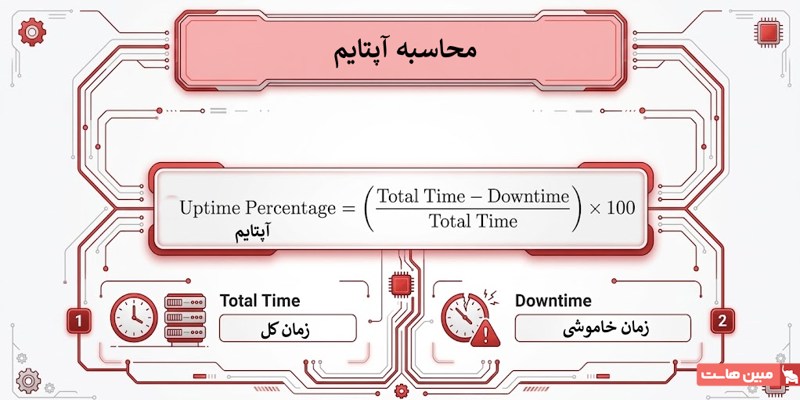
در سامانههایی با قابلیت تعمیر و بازیابی، مهندسان قابلیت اطمینان پایداری ذاتی سیستم را با دو شاخص کلیدی زیر فرمولبندی میکنند که عبارتاند از:
- شاخص MTBF (میانگین زمان بین خرابیها): متوسط زمان کارکرد بدون نقص سیستم قبل از وقوع هرگونه ایراد یا توقف.
- شاخص MTTR (میانگین زمان لازم برای تعمیر): میانگین زمانی که تیم فنی برای رفع خرابی و بازگرداندن سیستم به مدار نیاز دارد.
فرمول محاسبۀ دسترسیپذیری ذاتی بر اساس این دو معیار به شرح زیر است:

میزان پایداری سرورها در صنعت هاستینگ و فناوری اطلاعات معمولاً با اصطلاح تعداد ۹ها (Nines) سنجیده میشود. اضافه شدن هر رقم ۹ به معنای کاهش تصاعدی خطای مجاز و نیاز به افزونگی قویتر در زیرساخت است که جدول زیر جزئیات آنرا به ما نشان میدهد.
| سطح پایداری (تعداد ۹ها) | نام رایج | داونتایم مجاز در سال | داونتایم مجاز در ماه | داونتایم مجاز در هفته |
| ۹۰٪ | یک نه (One Nine) | ۳۶ روز و ۱۲ ساعت | ۳ روز و ۱ ساعت | ۱۶ ساعت و ۴۸ دقیقه |
| ۹۹٪ | دو نه (Two Nines) | ۳ روز و ۱۵ ساعت و ۳۶ دقیقه | ۷ ساعت و ۱۸ دقیقه | ۱ ساعت و ۴۰ دقیقه |
| ۹۹.۹٪ | سه نه (Three Nines) | ۸ ساعت و ۴۵ دقیقه و ۳۶ ثانیه | ۴۳ دقیقه و ۵۰ ثانیه | ۱۰ دقیقه و ۵ ثانیه |
| ۹۹.۹۵٪ | سه و نیم نه | ۴ ساعت و ۲۲ دقیقه و ۴۸ ثانیه | ۲۱ دقیقه و ۵۵ ثانیه | ۵ دقیقه و ۲ ثانیه |
| ۹۹.۹۹٪ | چهار نه (Four Nines) | ۵۲ دقیقه و ۳۴ ثانیه | ۴ دقیقه و ۲۳ ثانیه | ۱ دقیقه |
| ۹۹.۹۹۹٪ | پنج نه (Five Nines) | ۵ دقیقه و ۱۵ ثانیه | ۲۶ ثانیه | ۶ ثانیه |
| ۹۹.۹۹۹۹٪ | شش نه (Six Nines) | ۳۱.۵ ثانیه | ۲.۶ ثانیه | ۰.۶ ثانیه |
هرچند آپتایم ۹۹.۹٪ برای بسیاری از وبسایتها آماری قابلقبول به حساب میآید، اما سیستمهای مالی جهانی به پایداری بسیار بالاتری نیاز دارند. به عنوان نمونه، طبق گزارش رسمی پلتفرم Stripe، این شرکت در رویداد بلک فرایدی و سایبر ماندی سال ۲۰۲۵ به آپتایم شگفتانگیز بیش از ۹۹.۹۹۹۹٪ (شش نُه) دست یافت. این زیرساخت توانست بیش از ۵۷۸ میلیون تراکنش مالی حساس را در اوج ترافیک بدون کوچکترین اختلالی پردازش کند.
4 معیار تکمیلی پایداری سیستم (فراتر از آپتایم ساده)
سنجش سلامت زیرساخت تنها با معیار آپتایم کافی نیست و نیازمند شاخصهای مکمل برای ارزیابی سرعت واکنش، نرخ خطا و کیفیت تجربۀ کاربری است.
۱) شاخصهای زمانی واکنش و هشدار (MTTD ،MTTA و MTTN)
این معیارها چابکی تیم فنی و اثربخشی سیستم مانیتورینگ را در مهار بحران اندازه میگیرند:
- MTTD (میانگین زمان تا تشخیص): فاصلۀ زمانی از لحظۀ وقوع خرابی تا کشف آن توسط سیستم هشدار.
- MTTA (میانگین زمان تا تایید): مدتزمان میان ارسال هشدار تا تایید دریافت آن توسط کارشناس مسئول.
- MTTN (میانگین زمان تا اطلاعرسانی): فاصلۀ زمانی کشف حادثه تا ارسال اعلان رسمی به کاربران متأثر.
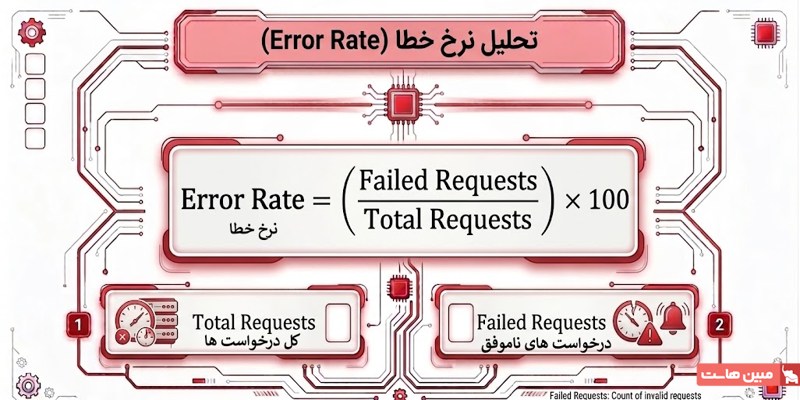
۲) تحلیل نرخ خطا (Error Rate)
این معیار نرخ خطا قطعیهای جزئی را ثبت میکند؛ وضعیتی که سرور پاسخ میدهد، اما پاسخها نامعتبرند (مانند کدهای سری ۵۰۰).
۳) پایش تأخیر بر اساس صدکها (Latency Percentiles: p95 و p99)
عملکرد این معیار به این شکل است که میانگین زمان پاسخدهی اختلالات عمیق را پنهان میکند؛ به همین دلیل از صدکها برای سنجش کندترین درخواستها استفاده میشود. این معیار نشان میدهد که ۹۵ یا ۹۹ درصد کاربران پاسخشان را با چه سرعتی دریافت کردهاند و عملکرد سیستم در بدترین سناریوها چگونه است.
۴) نرخ موفقیت تراکنشهای بحرانی (Critical User Journeys)
این معیار درصد تکمیل موفقیتآمیز مهمترین سناریوهای تجاری (نظیر پرداخت یا ورود به حساب) را فارغ از وضعیت انفرادی سرورها میسنجد.

چارچوب تعهدات پایداری: ارتباط میان SLA ،SLO و SLI
برای تبدیل مفهوم انتزاعی پایداری به تعهداتی دقیق و قابل سنجش، تیمهای مهندسی از چارچوب سهگانۀ SLA ،SLO و SLI بهره میبرند تا تعادل میان کیفیت سرویس و توسعۀ محصول حفظ شود.
۱) توافقنامۀ سطح خدمات (SLA) و پیامدهای مالی و حقوقی
قرارداد سطح خدمات (Service Level Agreement) سندی رسمی و حقوقی میان سرویسدهنده و مشتری است که حداقل سطح پایداری و آپتایم تضمینشده را تعیین میکند. در صورت نقض این تعهدات، ارائهدهنده ملزم به پرداخت خسارت به شکل اعتبار سرویس (Service Credit) یا جریمههای نقدی مصوب خواهد بود.
۲) اهداف سطح خدمات (SLO) و بودجۀ خطا (Error Budgets)
هدف سطح خدمات (Service Level Objective) تارگت داخلی تیم فنی برای پایداری سرویس است که همواره سختگیرانهتر از SLA تعیین میشود. اختلاف میان هدف SLO و پایداری ۱۰۰ درصدی، «بودجۀ خطا» نامیده میشود. مادامی که بودجۀ خطا نسوخته باشد، تیمها اجازۀ انتشار فیچرهای جدید پرریسک را دارند و در صورت اتمام آن، اولویت کل تیم به رفع باگهای زیرساختی تغییر میکند.
۳) نشانگرهای سطح خدمات (SLI) و نحوۀ گزینش آنها
شاخص سطح خدمات (Service Level Indicator) متغیر عددی و ملموسی است که تحقق یا عدم تحقق SLO را اندازهگیری میکند. پاسخ سادۀ پینگ سرور معیار نامناسبی برای سنجش سلامت است و یک SLI استاندارد باید مستقیماً تجربۀ واقعی کاربر مانند نسبت درخواستهای موفق به کل درخواستها یا تأخیر پاسخدهی را پایش کند.
مهمترین دلایل قطعی و افت آپتایم سرور و سایت
وقوع داونتایم معمولاً ناشی از یک عامل منفرد نیست و زنجیرهای از مشکلات فنی و زیرساختی در افت پایداری سیستم نقش دارند که از میان آنها عوامل زیر بیشترین تاثیر را دارند:
- خرابی قطعات سختافزاری سرور نظیر دیسک، رم و منبع تغذیه.
- باگهای نرمافزاری، نشت حافظه و انتشار کدهای تستنشده.
- خطاهای تفکیک نام دامنه و عدم دسترسی به رکوردهای شبکه.
- نمایش خطای امنیتی در مرورگر به دلیل انقضای گواهی SSL.
- حملات سنگین منع سرویس توزیعشده (DDoS) و ایجاد ترافیک جعلی.
- اشباع ظرفیت پردازنده، حافظه یا پورت شبکه در پیکهای ترافیکی.
- اشتباهات انسانی در اعمال تغییرات فایروال و بستن پورتهای ارتباطی.
مانیتورینگ آپتایم چیست و چطور پیادهسازی میشود؟
مانیتورینگ آپتایم فرایند بررسی خودکار و پیوستۀ وضعیت سرور یا وبسایت است تا مشخص شود سرویس در چه زمانهایی فعال بوده و در چه لحظاتی قطع شده است. در تیمهای فنی، اغلب دو اصطلاح «مانیتورینگ» (Monitoring) و «مشاهدهپذیری» (Observability) در کنار هم مطرح میشوند که هرچند مکمل یکدیگرند، اما دو کارکرد متفاوت دارند:
- مانیتورینگ: به این پرسش پاسخ میدهد که «کدام بخش و در چه زمانی قطع شده است؟» و صرفاً علائم ظاهری مثل در دسترس نبودن سرور را گزارش میکند.
- مشاهدهپذیری: به این پرسش پاسخ میدهد که «علت دقیق این قطعی چیست؟» و با تحلیل لاگها و جریان داخلی سیستم، ریشۀ خرابی را روشن میسازد.
سطوح اجرای مانیتورینگ
یک مانیتورینگ استاندارد، پایش سلامت سرویس را در چهار سطح زیر دنبال میکند:
- پایش صفحات و URLهای کلیدی: از طریق بررسی مداوم دسترسی به صفحات حساس نظیر فرم ورود و صفحه پرداخت.
- پایش پورتها و شبکه: با تست پاسخگویی سرور از طریق ارسال پکتهای پینگ (ICMP) و بررسی باز بودن پورتهای TCP و UDP.
- پایش رابطهای برنامهنویسی (API): به صورت بررسی صحت ارسال و دریافت دادهها در وبسرویسها.
- پایش زیرساخت و مسیر انتقال شبکه با ارزیابی سلامت روترها، مسیرهای اینترنت و سرورهای نام دامنه.
اختلال در لایۀ زیرساخت و شبکه معمولاً ناشی از عدم پاسخگویی سرورهای نام دامنه است؛ برای بررسی ریشهای این خطاها و نحوۀ رفع آنها، مطالعۀ راهنمای DNS چیست به شما کمک خواهد کرد.
راهکارهای جلوگیری از هشدارهای کاذب
ثبت خطاهای اشتباه میتواند تمرکز تیم فنی را برهم بزند. برای رفع این چالش دو سازوکار اصلی اعمال میشود:
- پایش از چند موقعیت جغرافیایی: بررسی وضعیت سایت از چندین سرور مختلف در جهان تا قطعیهای منطقهای اینترنت با داونتایم واقعی سرور اشتباه گرفته نشود.
- مکانیزم تکرار بررسی: ثبت نهایی وضعیت خرابی تنها پس از چند بار تلاش ناموفق یا تایید خطای همزمان توسط دو نود مجزا.
ابزارهای مانیتورینگ آپتایم
انتخاب ابزار پایش سلامت بستگی به معماری سیستم، میزان حساسیت دادهها و سطح نیاز تیم فنی به سفارشیسازی دارد. این راهکارها عموماً در چهار دستۀ اصلی زیر قرار میگیرند:
- ابری
- سلفهاست
- متنباز سریزمانی
- پلتفرمهای ارائهدهندگان کلود
جدول زیر جزئیات بیشتری از این ابزارها ارائه کرده است:
| دستهبندی ابزار | نمونههای شاخص | نحوه استقرار | مهمترین مزیت فنی |
| سرویسهای ابری و SaaS | Uptime.com، Pingdom، LogicMonitor | میزبانیشده توسط ارائهدهنده | راهاندازی سریع و پایش با نودهای توزیعشده جهانی |
| ابزارهای سلفهاست | Uptime Kuma، Zabbix، Icinga | استقرار روی سرور اختصاصی یا داخلی | کنترل کامل روی دادهها، امنیت بالا و عدم پرداخت هزینۀ دلاری |
| ابزارهای متنباز سریزمانی | Prometheus، Sensu | پیادهسازی متمرکز بر متریک و لاگ | امکان تحلیل بسیار دقیق لاگها و سازگاری با کانتینرها |
| ابزارهای بومی کلود | AWS CloudWatch، Azure Monitor، GCP | ادغام مستقیم با زیرساخت ابری | دید عمیق به منابع ماشین بدون نیاز به نصب ایجنت جداگانه |
پیامدهای تجاری، مالی و سئویی داونتایم
داونتایم تنها یک اختلال فنی گذرا نیست و توقف سرویس مستقیماً درآمدهای جاری، اعتماد مشتریان، جایگاه ارگانیک در موتورهای جستوجو و بودجههای بازاریابی را هدف قرار میدهد.
۱) ضررهای مالی سنگین در ابعاد سازمانی
توقف خدمات آنلاین به معنای مسدود شدن مستقیم جریان فروش و آسیب به ارزش کسبوکار است. بر اساس گزارش رسمی شرکت Splunk (با عنوان The Hidden Costs of Downtime)، قطعیهای ناخواسته سالانه ۶۰۰ میلیارد دلار به بزرگترین شرکتهای تجاری جهان زیان میزند.
طبق این پژوهش، سازمانها بهطور میانگین سالانه ۳۰۰ میلیون دلار بر اثر داونتایم از دست میدهند و ارزش سهام آنها تنها پس از یک تجربۀ قطعی بزرگ، بهطور متوسط ۳.۴ درصد افت میکند. این ارقام نشان میدهند که پایداری زیرساخت یک متغیر کلیدی در حفظ ارزش تجاری سازمان است.
۲) افت وفاداری مشتری و نرخ ریزش کاربران
کاربران وب برای دسترسی دوباره به سیستمهای ناپایدار معمولاً صبوری پیشه نمیکنند. اصطکاک ناشی از قطعی سرور یا خطاهای مکرر در زمان خرید، بیش از ۸۰ درصد مخاطبان را از بازگشت دوباره منصرف کرده و آنها را مستقیماً به سوی رقبا سوق میدهد. از دست رفتن این مشتریان ارزش طول عمر کاربر (LTV) را کاهش داده و هزینههای جذب مشتری جدید (CAC) را دوچندان میکند.
۳) ریزش رتبههای ارگانیک و افت بودجۀ خزش سئو
هنگامی که رباتهای گوگل با خطاهای سری ۵xx یا عدم پاسخدهی سرور مواجه میشوند، برای جلوگیری از فشار مضاعف بر زیرساخت آسیبدیده، سرعت خزش (Crawl Rate) را کاهش میدهند. در صورتی که این ناپایداری چند ساعت یا چند روز متوالی ادامه یابد، گوگل برای حفظ کیفیت نتایج، صفحات غیرقابلدسترس را بهمرور از ایندکس نتایج جستوجو خارج میکند؛ اقدامی که پیامد آن ریزش شدید رتبههای کلیدی و از دست رفتن ترافیک ارگانیک خواهد بود.
تیم مهندسی گوگل در مستندات رسمی خود با عنوان Debug network and DNS errors for Google’s crawlers به صراحت در این باره مینویسد:
«داونتایم و خطاهای ارتباطی شبکه مستقیماً فرایند کراول و ایندکس محتوا را مختل میکنند. گوگل با خطاهای شبکه، تایماوت و خطاهای تفکیک DNS دقیقاً مشابه خطاهای سری ۵xx رفتار میکند. هنگامی که سرور پاسخگو نیست، گوگل برای جلوگیری از وارد آمدن بار اضافه به زیرساخت، بلافاصله سرعت خزش (Crawl Rate) را کاهش میدهد و در صورت تداوم قطعی، صفحات از پیش ایندکسشده را ظرف چند روز بهطور کامل از نتایج جستجو حذف خواهد کرد.»
۴) هدررفت سرمایه در کمپینهای تبلیغاتی (Google Ads)
هدایت ترافیک تبلیغات کلیکی به سایتی که با داونتایم مواجه است، خسارتی دوطرفه دارد: هزینۀ کلیکها بدون کمترین شانس برای تبدیل به فروش هدر میرود و الگوریتمهای گوگل ادز به دلیل تجربۀ فرود ناموفق کاربر (Landing Page Experience)، امتیاز کیفی تبلیغات را بهشدت کاهش میدهند. پیادهسازی اسکریپتهای توقف خودکار تبلیغات در زمان افت آپتایم، تنها راهکار قطعی برای جلوگیری از سوختن بودجه ادوردز در زمان قطعی سرور است.
راهکارهای عملی برای افزایش آپتایم و کاهش داونتایم
حفظ پایداری سیستم نیازمند رویکردی دومرحلهای است؛ مرحله اول بر پیشگیری از وقوع خرابی تمرکز دارد و مرحله دوم، زمان بازگشت به سرویس (MTTR) را پس از بروز بحران به حداقل میرساند.
استراتژیهای پیشگیری (افزایش آپتایم)
این راهکارها احتمال بروز اختلال در عملکرد سرویس را قبل از تأثیرگذاری بر کاربر خنثی میکنند:
- افزونگی سختافزاری و زیرساختی: استفاده از منابع تغذیۀ موازی، دیسکهای RAID و اتصال همزمان به چند ارائهدهندۀ پهنای باند برای حذف نقاط منفرد شکست (SPOF).
- توزیع بار ترافیکی: هدایت هوشمند درخواستهای کاربران میان چندین سرور فعال جهت جلوگیری از اشباع منابع یک ماشین خاص.
- مقیاسپذیری خودکار: تخصیص پویای منابع پردازنده و رم در لحظات جهش ترافیکی، بهمنظور ممانعت از کرش کردن سیستم زیر بار سنگین.
- پیادهسازی لایههای کَش و شبکه توزیع محتوا: ذخیرهسازی دادههای پرتکرار روی حافظۀ رم (نظیر Redis) و بهرهگیری از زیرساختهای لبه شبکه.
برای آشنایی با نقش فناوری CDN در پایداری و کاهش فشار روی سرور اصلی، مقاله CDN چیست را بخوانید.
استراتژیهای واکنش سریع (کاهش داونتایم)
در صورت بروز نقص فنی پیشبینینشده، این اقدامات پایداری سرویس را در کمترین زمان بازیابی میکنند:
- مکانیزم انتقال خودکار ترافیک: هدایت بدون وقفه درخواستها به سرور یا دیتاسنتر پشتیبان در لحظۀ عدم پاسخگویی سرور اصلی.
- مهندسی آشوب و شبیهسازی بحران: تزریق عمدی خرابیهای کنترلشده در محیط عملیاتی برای کشف نقاط ضعف سیستم پیش از وقوع بحران واقعی.
- طرح بازیابی پس از فاجعه: تدوین دستورالعملهای دقیق گامبهگام به همراه پشتیبانگیری منظم خارج از سایت (Off-site Backup) برای احیای پایگاه داده و نرمافزارها در کوتاهترین زمان.
چالش مانیتورینگ و آپتایم برای وبمسترهای ایرانی
مدیریت پایداری سرور در ایران پیچیدگیهای مضاعفی دارد. تحریمهای بینالمللی مانع دسترسی آسان به حسابهای تجاری پلتفرمهای ابری (نظیر Pingdom یا New Relic) و پرداختهای ارزی شده است. از طرف دیگر، ارسال درخواستهای پایش از نودهای خارج از کشور به سرورهای دیتاسنتر داخلی، به دلیل نوسانات اینترنت بینالملل هشدارهای کاذب (False Positive) فراوانی تولید میکند. این در حالی است که سایت برای کاربران داخل ایران بدون مشکل باز میشود.
برای حل این معضل، تیمهای فنی ایرانی معمولاً ابزارهای سلفهاست و متنبازی مانند Uptime Kuma یا Zabbix را روی سرورهای داخلی مستقر میکنند تا وضعیت دسترسیپذیری را مستقیماً از درون شبکه کشور بسنجند.
میزبانی پایدار با خدمات سرور اختصاصی و مجازی مبینهاست
تضمین دسترسی مداوم به سرویس، پیش از هر چیز به بستر میزبانی استاندارد، سختافزارهای پایدار و شبکه ارتباطی افزونه وابسته است. برای وبسایتها و پلتفرمهای روبهرشد، بهرهگیری از خدمات سرور مجازی مبینهاست امکان مقیاسپذیری سریع منابع و پایداری پایدار در ترافیکهای متغیر را فراهم میکند. از طرف دیگر، سازمانها و کسبوکارهای پرترافیک با اتکا به خدمات سرور اختصاصی میتوانند از بالاترین سطح امنیت، منابع کاملاً ایزوله و پشتیبانی فنی ۲۴ ساعته در تمام روزهای سال بهرهمند شوند و ریسک افت آپتایم را به حداقل برسانند.
دستیابی به پایداری حداکثری، هدفی مقطعی نیست؛ بلکه خروجی مستقیم طراحی معماری تابآور، مانیتورینگ چندلایه و انتخاب هوشمندانه زیرساخت میزبانی است. با پایدارسازی لایههای شبکه و سرور، اثرات مخرب قطعیهای غیرمنتظره مهار شده و تداوم رشد کسبوکار آنلاین تضمین میشود.
جمعبندی
همانطور که در این مطلب بررسی کردیم، آپتایم فقط عددی برای نمایش میزان روشنبودن سرور نیست. این شاخص زمانی معنا پیدا میکند که در کنار دسترسیپذیری، نرخ خطا، زمان پاسخدهی و وضعیت واقعی سرویس از دید کاربر بررسی شود. به همین دلیل، داشتن آپتایم بالا بهتنهایی تضمین نمیکند که تمام بخشهای سایت یا سرویس بدون مشکل در دسترس کاربران باشند.
برای حفظ پایداری، باید هم روی پیشگیری از قطعی و هم روی کاهش زمان بازیابی پس از خرابی تمرکز کرد. مانیتورینگ مستمر، افزونگی زیرساخت، توزیع بار، مقیاسپذیری مناسب و داشتن برنامۀ بازیابی، همگی بخشی از همین رویکرد هستند. در کنار آن، بررسی سرویس از چند نقطه و پایش بخشهای مهمی مثل URLها، پورتها و APIها کمک میکند مشکلات زودتر شناسایی شوند و هشدارهای اشتباه هم کاهش پیدا کنند.
در عمل، هدف این نیست که فقط عدد آپتایم بالاتری در گزارشها دیده شود؛ بلکه مهم این است که سایت یا سرویس در زمانی که کاربر به آن نیاز دارد، واقعاً قابل استفاده و پایدار باشد. رسیدن به چنین وضعیتی به ترکیبی از زیرساخت مناسب، مانیتورینگ چندلایه و واکنش سریع در زمان بروز اختلال وابسته است.