فایل robots txt یک فایل متنی ساده در ریشۀ هاست است که به خزندههای موتورهای جستوجو اعلام میکند به کدام بخشها، فایلها یا آدرسهای وبسایت شما دسترسی داشته باشند و از کدام بخشها دوری کنند. این فایل در وهلۀ اول برای مدیریت ترافیک رباتها و جلوگیری از تحمیل بار اضافی بر سرور مورد استفاده قرار میگیرد و نقش مهمی در سازماندهی رفتار خزندهها در کل سایت دارد. بنابراین اگر به درستی پیکربندی نشود، دسترسی خزندهها به صفحات مهم سایت با اختلال مواجه خواهد شد.
اگر میخواهید بدانید فایل robots txt چیست و چه تاثیری روی سئوی سایت دارد، تا آخر این نوشته از وبلاگ مبین هاست همراه ما باشید.
فایل robots.txt چیست و چگونه کار میکند؟
فایل robots.txt در واقع نوعی سند متنی ساده بر پایۀ پروتکل استثنای خزندهها (Robots Exclusion Protocol) است که در ریشۀ هاست قرار میگیرد و محدوده دسترسی خزندههای وب را مشخص میکند. این فایل مشابه یک تابلوی راهنمای رفتاری در ورودی سایت عمل میکند تا باتها بخشهای مجاز و غیرمجاز را تشخیص دهند، بیآنکه مانعی فیزیکی برای بستن مسیرها ایجاد کند.
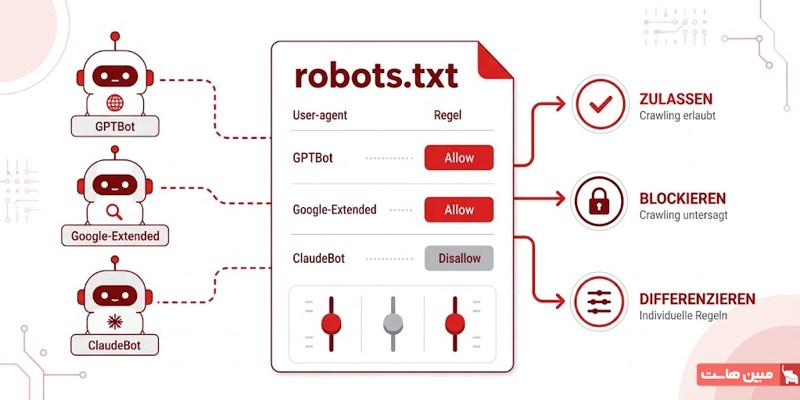
نحوۀ کار فایل robots txt در زمان ورود رباتها به سایت بسیار ساده و به صورت زیر است:
- ربات موتور جستوجو (مثل گوگل) قبل از دیدن هر صفحهای، اول فایل robots.txt سایت شما را باز میکند.
- ربات متن داخل فایل را میخواند تا ببیند چه دستوراتی برای او نوشته شده است.
- اگر صفحهای را ممنوع کرده باشید، ربات آن را باز نمیکند و وقتش را روی آن تلف نمیکند.
- اگر صفحهای آزاد باشد، ربات وارد آن صفحه میشود و محتوای آن را میخواند.
پایبندی رباتها به این دستورات هم دو حالت بیشتر ندارد:
- رباتهای معتبر مثل گوگل و بینگ کاملاً به این تابلوی ورود ممنوع احترام میگذارند و وارد صفحات مسدود نمیشوند.
- رباتهای مخرب و دزدان محتوا (اسکرپرها) به این تابلو اهمیتی نمیدهند و حتی وارد بخشهای مسدود میشوند.
یک نکتۀ فنی مهم پیش از شروع: استاندارد وب و نام فنی و معتبر این سند منحصراً robots.txt با حروف کوچک و علامت جمع است؛ نگارشهایی نظیر Robot.txt که در عنوانها یا عبارات جستوجو میبینید، صرفاً اصطلاحات مصطلح کاربران و اشتباهات رایج جستوجو هستند و استفاده از هر نام دیگری غیر از robots.txt توسط سرور و رباتها نادیده گرفته میشود.
کاربردهای Robot.txt چیست؟
فایل robots.txt ابزاری برای مدیریت نحوۀ دسترسی و هدایت خزندههای وب در بخشهای مختلف وبسایت است. استفادۀ اصولی از این فایل امکانات و مزایای زیر را در اختیار وبمسترها قرار میدهد، از جمله موارد زیر:
- جلوگیری از خزش صفحات مدیریتی و مسیرهای خصوصی سایت؛
- بهینهسازی بودجۀ خزش (Crawl Budget) با بستن صفحات تکراری و کمارزش؛
- کاهش مصرف منابع سرور و جلوگیری از افت سرعت ناشی از درخواست رباتها؛
- هدایت خزندههای موتور جستوجو به نشانی دقیق نقشۀ سایت (Sitemap)؛
- مسدودسازی دسترسی رباتهای آموزشی هوش مصنوعی و اسکرپرهای خودکار.
به این موضوع توجه داشته باشید که فایل robots txt یک ابزار امنیتی نیست و نمیتواند مانع نمایش قطعی نشانی صفحه در گوگل شود. برای حذف کامل یک صفحه از نتایج جستوجو باید از متاتگ noindex استفاده کنید.
چرا فایل robots txt برای سئو حیاتی است؟
موتورهای جستوجو زمان و توان محدودی را برای بررسی هر وبسایت اختصاص میدهند که در دنیای وب به آن بودجۀ خزش میگویند. تنظیم اصولی فایل robots txt تضمین میکند که خزندهها وقت خود را روی صفحات بیارزش هدر ندهند و تمرکزشان را مستقیماً روی محتوای رتبهساز شما بگذارند. مهمترین دلایل اهمیت فایل robots txt برای بهبود وضعیت فنی سایت به شرح زیر است:
- مدیریت بودجه خزش: خزندهها بهجای بررسی صفحات کماهمیت، مستقیماً به سراغ صفحات اصلی و محصولات کلیدی هدایت میشوند.
- کاهش فشار روی سرور: جلوگیری از ارسال درخواستهای همزمان و مکرر توسط رباتها، مانع از افت سرعت سایت و اشغال رم و سیپییو میشود.
- مهار صفحات تکراری: مسیر آدرسهای فیلترشده، پارامترهای جستوجوی داخلی و صفحات دستهبندی تکراری برای رباتها بسته میشود تا افت رتبه رخ ندهد.
- هدایت سریع به نقشه سایت: ثبت آدرس سایتمپ در این سند به موتورهای جستوجو کمک میکند تا بدون سردرگمی، کل ساختار محتوایی سایت را کشف کنند.
اگر میخواهید فرایند بهینهسازی فنی را عمیقتر درک کنید و بدانید این تنظیمات چطور باعث رشد جایگاه سایت در گوگل میشوند، حتماً مقالۀ سئو چیست را مطالعه کنید.
تفاوت حیاتی robots.txt با متاتگ noindex (اشتباه رایج وبمسترها)
بسیاری از افراد تازه کار تصور میکنند اگر صفحهای را در فایل robots txt مسدود کنند، آن صفحه دیگر در نتایج گوگل دیده نمیشود. این فایل فقط جلوی ورود و خواندن محتوا توسط رباتها را میگیرد، در حالی که حذف کامل یک صفحه از نتایج جستوجو به ابزار دیگری به نام متاتگ noindex نیاز دارد. تفاوت عملکرد این دو روش در جدول زیر مشخص است:
| ویژگی | دستور Disallow در فایل robots txt | متاتگ noindex |
| محل درج | ریشۀ اصلی هاست سایت | کدهای HTML هر صفحه |
| اثر روی خزش (Crawl) | ورود خزندهها را متوقف میکند | مانع خزش صفحه نمیشود |
| اثر روی ایندکس (Index) | نشانی صفحه ممکن است ایندکس شود | صفحه به طور قطعی از نتایج حذف میشود |
| هدف اصلی | مدیریت ترافیک سرور و بودجه خزش | پنهان کردن محتوا از دید کاربران جستوجو |
در صورت ترکیب اشتباه این دو روش، مشکلات زیر رخ میدهد:
- دستور Disallow مانع پیدا شدن صفحه از طریق لینکهای دیگر سایتها نمیشود.
- صفحۀ مسدودشده بدون عنوان و متن مناسب در نتایج گوگل نمایش داده میشود.
- ربات گوگل به دلیل بسته بودن مسیر، کد noindex درون صفحه را هرگز نمیخواند.
دستورات اصلی و سینتکس فایل Robot.txt چیست؟
دستورات این سند متنی بر پایۀ چند خط ساده نوشته میشوند که مشخص میکنند چه رباتی اجازۀ دسترسی به کدام بخشهای سایت را دارد. برای نوشتن این دستورها از استانداردی معینی استفاده میشود که هستۀ اصلی آن در جدول زیر خلاصه شده است:
| دستور | کاربرد اصلی | نمونۀ ساده |
| User-agent | مشخص کردن نام ربات هدف | User-agent: Googlebot |
| Disallow | مسدود کردن مسیر یا صفحه | /Disallow: /admin |
| Allow | باز کردن دسترسی در مسیر مسدود | Allow: /admin/ajax.php |
| Crawl-delay | ایجاد تاخیر بین درخواستها | Crawl-delay: 5 |
| Sitemap | معرفی آدرس نقشه سایت | Sitemap: [https://site.com/sitemap.xml](https://site.com/sitemap.xml) |
در ادامۀ این بخش، به توضیح جامعتر هر یک از دستورات بالا میپردازیم.
دستور User-agent (شناسایی رباتها)
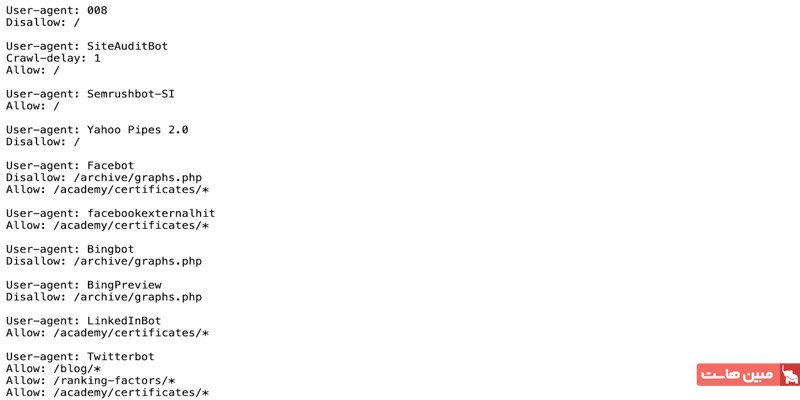
این خط در فایل robots txt معین میکند دستورات بعدی برای کدام خزنده نوشته شدهاند. اگر علامت ستاره (*) درج شود، قانون روی تمام رباتها اعمال خواهد شد، اما با نوشتن نام اختصاصی، دستور فقط برای همان ربات اجرا میشود.
User-agent: *
دستور Disallow (بستن مسیرها)
این دستور مانع ورود ربات به یک صفحه، پوشۀ مشخص یا کل سایت میشود. برای نمونه، نوشتن یک اسلش روبهروی این دستور کل سایت را میبندد، اما خالی گذاشتن جلوی آن به معنای باز بودن تمامی مسیرها است.
نمونه کد:
User-agent: *

Disallow: /private-folder/
دستور Allow (ایجاد استثنا برای فایلها)
این فرمان زمانی به کار میرود که پوشهای را به طور کامل مسدود کردهاید، اما میخواهید یک فایل خاص از درون آن باز بماند. به عنوان نمونه در سایتهای وردپرسی برای دسترسی خزندهها به فایل ارتباطی سیستم، استثنا تعریف میشود.
User-agent: *

Disallow: /wp-admin/

Allow: /wp-admin/admin-ajax.php
کاراکترهای الگوسازی (* و $)
برای مسدودسازی دستهای از لینکها بدون نیاز به نوشتن تکتک آدرسها، از دو علامت کمکی زیر استفاده میشود:
- علامت ستاره (*): به عنوان جانشین هر نوع عبارت متغیر به کار میرود تا لینکهای پارامتردار و فیلترها مسدود شوند.
- علامت دلار ($): نقطۀ پایان آدرس را مشخص میکند و برای مسدود کردن فرمتهای خاص کاربرد دارد.
به نمونۀ زیر دقت کنید:
User-agent: *

Disallow: /*?

Disallow: /*.pdf$
دستور Crawl-delay (تنظیم تاخیر خزش)
این دستور مدتزمان انتظار ربات بین هر درخواست را مشخص میکند تا منابع سرور کمتر مصرف شوند. موتورهای جستوجویی نظیر بینگ این قانون را میپذیرند، اما خزندههای گوگل آن را نادیده میگیرند.
User-agent: Bingbot

Crawl-delay: 10
نحوۀ مسدودسازی رباتهای هوش مصنوعی (AI Bots)
برای محافظت از محتوا در برابر خزندههای آموزش مدلهای زبانی، میتوان نام اختصاصی آنها را هدف قرار داد و دسترسی را بست.
User-agent: GPTBot

Disallow: /
توجه داشته باشید که عملکرد تمام رباتهای هوش مصنوعی یکسان نیست. ربات GPTBot صرفاً برای جمعآوری داده و آموزش مدلهای زبانی به کار میرود، در حالی که رباتهایی نظیر OAI-SearchBot و ChatGPT-User وظیفۀ جستوجوی زندۀ وب، پاسخدهی به کاربران در لحظه و ارجاع ترافیک به وبسایتها را دارند. مسدود کردن این رباتها باعث میشود وبسایت شما از نتایج جستوجوی لحظهای ابزارهایی مانند چتجیپیتی حذف شود؛ بنابراین توصیه میشود دسترسی آنها را باز بگذارید.
چگونه فایل robots txt بسازیم؟ (روشهای دستی و سایت ساخت فایل txt)
ساخت این فایل متنی پیچیدگی فنی بالایی ندارد، اما رعایت چند اصل اولیه برای خوانده شدن آن توسط خزندهها ضروری است. برای پیادهسازی و راهاندازی این فایل در سایت، روشهای متعددی وجود دارد که از ابزارهای آنلاین تا ساخت دستی را شامل میشود. پیش از شروع ساخت، رعایت الزامات پایهای زیر اهمیت زیادی دارد:
- نام فایل باید دقیقاً بهصورت حروف کوچک و با فرمت متنی یعنی robots.txt ذخیره شود.
- فرمت کدگذاری متنی حتماً باید بر روی UTF-8 تنظیم باشد تا خزندهها کاراکترها را بدون خطا بخوانند.
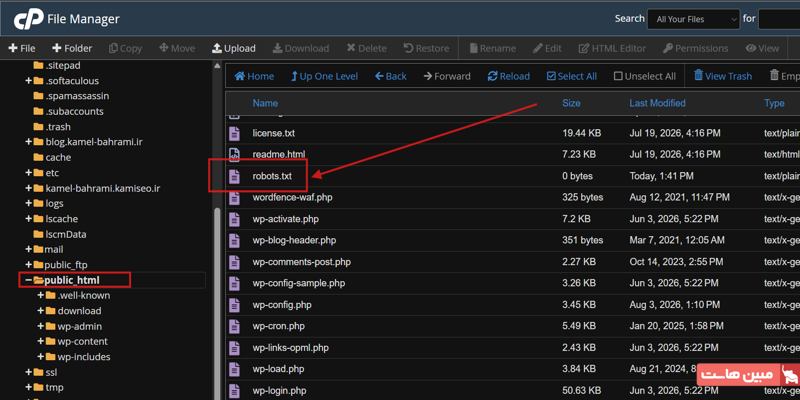
- این فایل باید در پوشۀ ریشۀ اصلی هاست (پوشۀ public_html) قرار گیرد تا با آدرس [yourdomain.com/robots.txt](https://yourdomain.com/robots.txt) باز شود.
۱) ساخت دستی با نرمافزارهای ویرایش متن (Notepad)
سادهترین شیوه برای مدیریت مستقیم دستورات، استفاده از برنامههای سادۀ متنی مانند Notepad در ویندوز است.
- یک فایل متنی ساده (Text Document) جدید ایجاد کنید و نام آن را robots.txt بگذارید.
- دستورات مدنظر خود مثل User-agent و مسیرهای مجاز یا غیرمجاز را داخل آن تایپ کنید.
- موقع ذخیره فایل، انکودینگ را روی گزینه UTF-8 بگذارید.
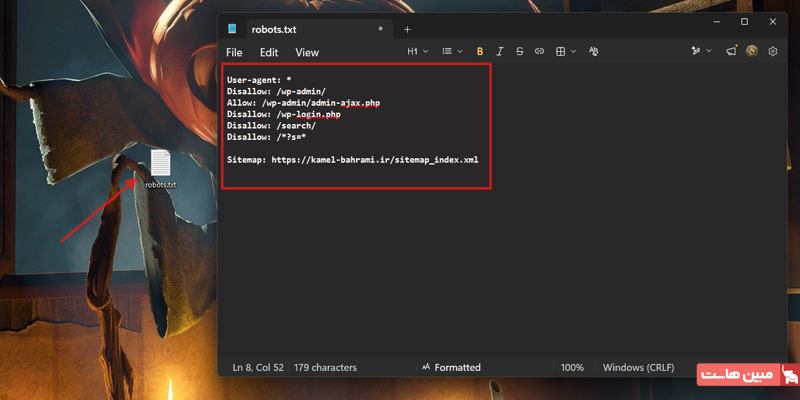
- فایل فایل robots txt آماده را از طریق پنل مدیریت هاست (cPanel یا DirectAdmin) یا نرمافزارهای FTP مستقیماً داخل ریشه سایت بارگذاری کنید.
۲) استفاده از سایت ساخت فایل txt (ژنراتورهای آنلاین)
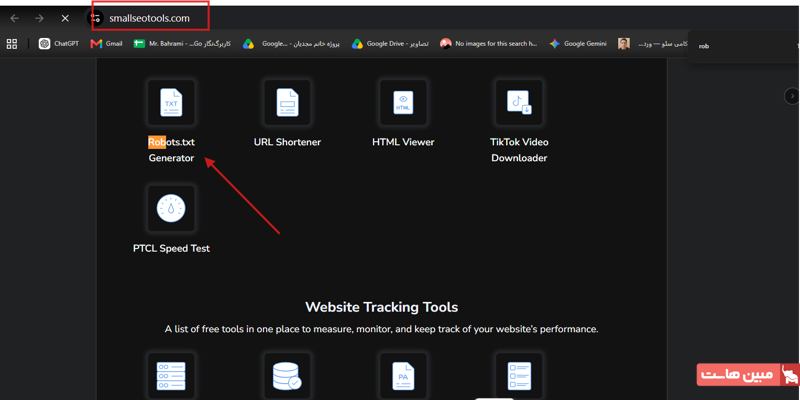
اگر به نوشتن دستی کدها مسلط نیستید، ابزارهای اینترنتی به شما کمک میکنند تا تنها با چند کلیک و پر کردن فرمهای آماده، فایل خود را دریافت کنید. انواع سایت ساخت فایل txt به نام Robots.txt Generator (مانند ابزارهای آنلاین وبسایتهای سئو نظیر SmallSEOTools یا SureMethods) امکان تعیین دسترسی رباتهای مختلف را به شکل دیداری فراهم میسازند. فرایند ایجاد خروجی در سایت ساخت فایل txt به شرح زیر است:
- وارد ابزار آنلاین Robots.txt Generator شوید و ابزار مد نظر را طبق تصویر زیر انتخاب کنید.
- وضعیت دسترسی پیشفرض رباتها را روی حالت مجاز (Allowed) قرار دهید.
- مسیر پوشههای غیرضروری (مانند wp-admin/ یا cgi-bin/) را در کادر مسدودسازی وارد کنید.
- آدرس کامل نقشۀ سایت (Sitemap URL) خود را در کادر مربوطه ثبت کنید.
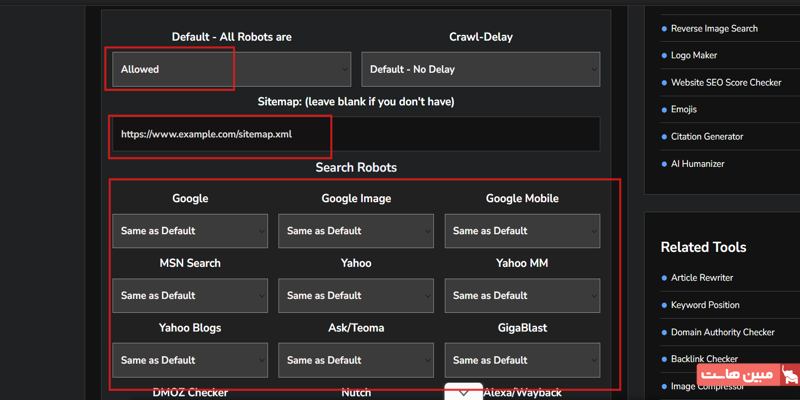
- روی دکمۀ Create Robots.txt کلیک کنید تا متن نهایی آماده شود.
- خروجی متن را کپی کنید یا فایل متنی ساختهشده را دانلود کرده و در هاست بارگذاری کنید.
۳) ساخت و مدیریت در وردپرس با افزونههای سئو
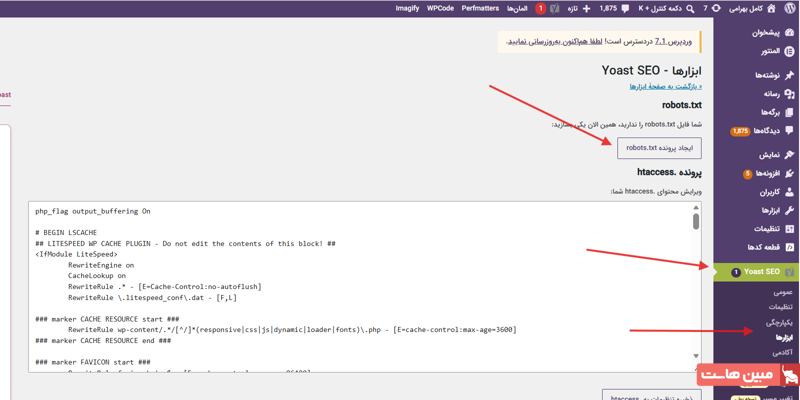
در سیستم مدیریت محتوای وردپرس معمولاً یک نسخۀ پیشفرض از فایل robots txt وجود دارد، اما برای شخصیسازی آسان و بدون نیاز به ورود به کنترلپنل هاست، افزونههای سئو بهترین راهحل هستند. مراحل انجام ساخت فایل Robots.txt در افزونههای رنگ مث و یوست به شرح زیر است:
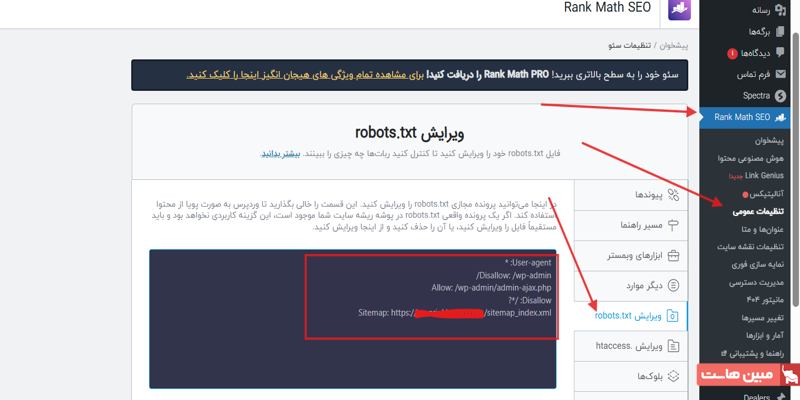
- افزونۀ رنک مث (Rank Math): در منوی پیشخوان وردپرس، بخش «تنظیمات عمومی» و سپس زبانه «ویرایش robots.txt» را باز کنید تا کدهای متنی را مستقیماً از داخل سایت اصلاح و ذخیره کنید.
- افزونۀ یوست (Yoast SEO): از منوی یوست سئو وارد قسمت «ابزارها» شوید و گزینۀ «ویرایشگر فایل» را انتخاب کنید تا امکان ویرایش فوری کدهای این فایل برای شما فعال شود.
نحوۀ تست و عیبیابی فایل robots.txt
پس از ساخت و بارگذاری فایل، بررسی صحت عملکرد آن ضروری است؛ زیرا یک اشتباه کوچک در دستورات میتواند مانع از ورود رباتها به صفحات کلیدی شود. روشهای متداول برای بررسی و عیبیابی این فایل به شرح زیر است:
بررسی مستقیم در مرورگر
با وارد کردن آدرس [yourdomain.com/robots.txt](https://yourdomain.com/robots.txt) در نوار آدرس، میتوانید از بارگذاری صحیح و عمومی بودن فایل متنی مطمئن شوید.

استفاده از ابزار URL Inspection سرچ کنسول
با توجه به منسوخ شدن ابزار قدیمی تستر گوگل، آدرس هر صفحه را در کادر بالای سرچ کنسول (ابزار URL Inspection) وارد کنید و با زدن دکمۀ Test Live URL مطمئن شوید وضعیت خزش در حالت مجاز (Yes) یا مسدودشده (Blocked) قرار دارد.

گوگل در سرچ کنسول یک بخش اختصاصی به نام robots.txt report دارد که وضعیت دریافت فایل، تاریخ آخرین خزش، هشدارهای نحوۀ نگارش و خطاهای دسترسی سرور را برای دامنههای مختلف نشان میدهد. شما از طریق این گزارش میتوانید نسخۀ ذخیرهشدۀ فایل در کش گوگل را ببینید و در صورت اعمال ویرایشهای حیاتی، مستقیماً از دکمۀ درخواست بازخوانی مجدد استفاده کنید تا گوگلبات سریعتر نسخۀ جدید را شناسایی کند.
توجه داشته باشید که موتور جستوجوی گوگل دستور Crawl-delay درون فایل robots.txt را نادیده میگیرد؛ بنابراین اگر خزشهای مکرر باعث فشار بر سرور و کندی سایت میشود، نباید به نوشتن تأخیر در این فایل تکیه کنید. برای کنترل این موضوع، میتوانید به بخش تنظیمات سرچ کنسول (Settings) و سپس آمار خزش (Crawl stats) مراجعه کنید تا رفتار باتها را رصد کنید. همچنین در شرایطی که سرور با بار کاری شدید مواجه است، میتوانید درخواست کاهش نرخ خزش (Crawl rate) را از طریق تنظیمات سرچ کنسول به گوگل ارسال کنید تا تعداد درخواستهای ارسالی موقتاً محدود شود.
شبیهسازی با اسکریمینگ فراگ (Screaming Frog)
این نرمافزار خزش وب را شبیهسازی میکند و صفحات بستهشده توسط فایل متنی را به همراه خطاهای مسدودسازی گزارش میدهد.
اشتباهات جبرانناپذیر در تنظیم فایل robots txt که به رتبۀ سایت ضربه میزنند
یک خطای کوچک در نگارش این فایل میتواند دسترسی خزندهها را به بخشهای اصلی سایت مسدود کند و باعث افت ناگهانی رتبهها در گوگل شود. رایجترین خطاهای خطرناک در تنظیم فایل robots txt شامل موارد زیر است:
- بستن دسترسی فایلهای CSS و JS: موتورهای جستوجو برای درک چیدمان بصری و واکنشگرایی صفحه به این فایلها نیاز دارند و مسدود کردن آنها رندر صفحه را مختل میکند.
- نادیده گرفتن سابدامینها: هر زیردامنه به عنوان یک سایت جداگانه شناخته میشود و فایل دامنۀ اصلی روی سابدامینها اعمال نخواهد شد.
- قرار دادن اشتباه اسلش (/ :Disallow): نوشتن این دستور روبهروی نام رباتها کل وبسایت را مسدود میکند و فرایند خزش تمامی صفحات متوقف میشود.
- رعایت نکردن بزرگی و کوچکی حروف: سیستمهای سرور و خزندهها به حروف حساس هستند و استفاده از حروفی مثل Robots.TXT باعث ناشناخته ماندن فایل میشود.
کلام آخر
فایل robots txt نخستین نقطه تعامل میان وبسایت شما و خزندههای موتورهای جستجو است. تنظیم دقیق این سند متنی نقش مهمی در کاهش مصرف منابع هاست، بهینهسازی بودجه خزش و هدایت هوشمندانه باتها به بخشهای ارزشمند سایت دارد؛ اما نباید آن را ابزاری برای پنهانسازی اطلاعات حساس یا جلوگیری از ایندکس صفحات در نظر گرفت. با بررسی مستمر این فایل و پرهیز از مسدودسازی منابع حیاتی، مسیر ورود موتورهای جستوجو به محتوای اصلی سایت همواره هموار خواهد ماند.
منابع
سوالات متداول
خیر؛ این فایل صرفاً از ورود رباتها و خزش محتوا جلوگیری میکند. چنانچه سایر صفحات سایت یا وبسایتهای دیگر به آدرس مسدودشده لینک داده باشند، گوگل همچنان میتواند آن نشانی را بدون محتوا در نتایج جستوجو ایندکس کند. اگر هدف شما حذف قطعی و کامل یک صفحه از نتایج گوگل است، نباید آن را در robots.txt ببندید؛ بلکه باید مسیر خزش را باز بگذارید تا موتور جستوجو تگ noindex موجود در صفحه را بخواند و اجرا کند.
خیر، وجود این فایل از نظر ساختاری اجباری نیست و در نبود آن، خزندهها تمام مسیرهای عمومی سایت را بدون محدودیت بررسی میکنند. بااینحال، داشتن این فایل حتی برای سایتهای کوچک بهشدت توصیه میشود؛ چرا که برای مسدودسازی صفحات سیستمی و تکراری، معرفی نقشۀ سایت (Sitemap)، مدیریت بودجۀ خزش و پیشگیری از افت سرعت سرور ناشی از درخواستهای مکرر رباتها ابزاری کاملاً ضروری است.
از نظر استانداردهای وب و پروتکل استثنای خزندهها، هر زیردامنه یا سابدامین (مانند blog.yourdomain.com) یک میزبان کاملاً مستقل بهشمار میرود. خزندهها در بدو ورود به هر سابدامین، تنها فایل متنی بارگذاریشده در ریشۀ همان آدرس را جستوجو و اجرا میکنند؛ به همین دلیل، قوانین ثبتشده در دامنۀ اصلی به زیردامنهها ارث نمیرسد و برای مدیریت خزش هر بخش، باید یک فایل robots.txt جداگانه در روت همان سابدامین تعریف شود.
خیر؛ این فایل بر اساس استانداردهای وب باید کاملاً عمومی و در دسترس باشد تا خزندههای اینترنتی بتوانند پیش از ورود به سایت، قوانین آن را بخوانند. هر کاربری تنها با تایپ عبارت robots.txt/ در انتهای آدرس سایت میتواند محتوای این فایل را مشاهده کند؛ از این رو، هرگز نباید از دستور Disallow برای پنهانسازی مسیرهای فوقمحرمانه، دادههای حساس یا اطلاعات خصوصی سازمان به عنوان یک لایه امنیتی استفاده کنید.
گوگل معمولاً نسخۀ این فایل را به صورت موقت در حافظۀ کش خود ذخیره میکند و بهروزرسانی آن ممکن است از چند ساعت تا چند روز زمان ببرد. اگر تغییرات حساسی در فایل اعمال کردهاید و قصد دارید فرایند شناسایی را تسریع کنید، میتوانید از طریق بخش گزارش robots.txt در سرچ کنسول گوگل یا با درخواست بررسی در ابزار URL Inspection، موتور جستوجو را سریعتر از ویرایشهای جدید آگاه کنید.