وقوع حوادث ناگهانی در دنیای فناوری اجتنابناپذیر است و برای هر مدیر فنی یا صاحب کسبوکاری این سوال حیاتی مطرح میشود که Disaster Recovery چیست و چگونه مانع از توقف کامل خدمات و نابودی داراییهای دیجیتال میشود؛ در واقع، هدف غایی راهکارهای بازیابی این است که در زمان رخداد هر فاجعه، سرویسهای آنلاین با کمترین وقفه و بدون افت کیفیت به مدار کاری بازگردند.
در این مطلب از وبلاگ مبین هاست بررسی میکنیم که Disaster Recovery چیست، چه انواعی دارد و چگونه پیادهسازی میشود. با ما تا انتهای این مطلب همراه باشید.
Disaster Recovery چیست و چه کاربردی در کسبوکارها دارد؟
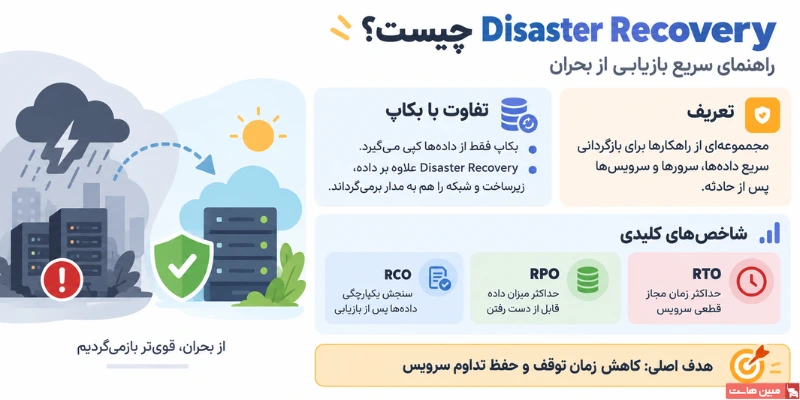
در پاسخ به این پرسش بنیادین که هویت Disaster Recovery چیست، میتوان گفت این مفهوم که در ادبیات فنی با عناوینی نظیر «بازیابی از فاجعه» یا «بازیابی از حادثه» شناخته میشود، چارچوبی سیستماتیک متشکل از راهکارهای فناوری، سیاستهای سازمانی و اقدامات واکنشی است. این مجموعهتدابیر طراحی شدهاند تا در زمان بروز حوادث فاجعهبار، سیستمهای نرمافزاری، پایگاههای داده و اتصالات شبکه در سریعترین زمان احیا شوند. بسیاری از افراد این فرایند را با پشتیبانگیری سنتی یکسان میپندارند، اما مرزهای شفافی میان آنها وجود دارد:
- بکاپ صرفاً کپیبرداری دورهای از فایلهاست و بهتنهایی قادر به روشن نگهداشتن پایدار سامانه نیست.
- فرایند بازنشانی فایلهای حجیم زمانبر است و قطعیهای طولانیمدت به بار میآورد.
- دیزستر ریکاوری افزون بر بازگردانی داده، زیرساخت پردازشی و مسیریابی شبکه را همزمان به مدار بازمیگرداند.
در فرایند پیادهسازی یک راهکار بازیابی از بحران، دو مکانیزم زیرساختی نقشی تعیینکننده دارند: اول، فرایند Failover که به معنای هدایت بلادرنگ ترافیک کاربران به سمت نودها و سرورهای آمادهبهکار هنگام سوختن سرور اصلی است و دوم، فرایند Failback که شامل انتقال امن و بازگشت پایدار پردازشها به زیرساخت اولیه پس از رفع کامل خرابی است. برای درک بهتر اینکه ارتباط مرزهای پایداری مداوم و Disaster Recovery چیست، مطالعۀ مطلب high availability چیست زاویۀ دید جامعی نسبت به تفاوت پایداری بدون وقفه با بازیابی حوادث فاجعهبار به شما ارائه میدهد.
تفاوت کلیدی Disaster Recovery با تداوم کسبوکار (BCP)
برای تفکیک درست اصطلاحات، باید بررسی کنیم مفهوم Disaster Recovery Plan چیست و چه تفاوتی با تداوم کسبوکار دارد. طرح بازیابی از فاجعه (DRP) یک سند فنی، اجرایی و عملیاتی است که مختص مهندسان فناوری اطلاعات تدوین میشود تا گامهای دقیق راهاندازی مجدد سرورها، دیسکها و تجهیزات ارتباطی پس از واقعه را تبیین کند.
در نقطۀ مقابل، برنامهریزی تداوم کسبوکار (Business Continuity Planning – BCP) چتری بسیار فراگیرتر است. برنامۀ BCP مدیریت کلان سازمان را دربرمیگیرد و مشخص میکند در بحرانهای بزرگی نظیر زلزله، جنگ یا اپیدمیهای فراگیر، چطور کارمندان از راه دور به فعالیت ادامه دهند، حقوق و دستمزدها پردازش شود، پاسخگویی به مشتریان حفظ شود و زنجیرۀ تأمین متوقف نشود. در حقیقت، طرح DRP تنها بازوی فنی و یکی از زیرمجموعههای حساس طرح تداوم کسبوکار به شمار میرود.
چه عواملی باعث ایجاد فاجعه در زیرساخت فناوری میشوند؟
تهدیداتی که پایداری سامانههای ابری و محلی را نشانه میگیرند، فراتر از حوادث طبیعی هستند و دامنهای وسیع از مخاطرات را شامل میشوند:
- سوانح فیزیکی و محیطی: مانند آتشسوزی در دیتاسنتر، قطعی گستردۀ برق شهری، زلزله، سیل و اختلال سیستمهای خنککننده رکها.
- نقص فنی در لایههای سختافزاری: مانند سوختن مادربرد، خرابی کنترلر دیسکهای ذخیرهسازی، و خرابی حافظۀ رم سرورها.
- رخنههای امنیتی و خرابکاری دیجیتال: مثل قفل شدن سرورها و باجگیری از سازمان با اجرای حملات سایبری.
- از کار انداختن شبکه و سرویس: مانند خاموش کردن مسیرهای ارتباطی زیر بار انبوهی از ترافیک جعلی ناشی از حملات DDOS.
- اشتباهات سهوی نیروی انسانی: به عنوان مثال اشتباه در تغییر پیکربندی روترها یا حذف اشتباهی دادهها حین نگهداری روزمره.
اگر بخواهیم بسنجیم که اهمیت Disaster Recovery در ابعاد مالی و اقتصادی چقدر است، گزارشهای تحلیلی موسسۀ Splunk که با همکاری Oxford Economics منتشر شدهاند، آمارهای تکاندهندهای ارائه میدهند. بر اساس این گزارشهای صنعتی، هزینۀ هر دقیقه دانتایم و توقف فعالیت برای سازمانهای بزرگ در سال 2026 به طور میانگین به بیش از ۱۵,۰۰۰ دلار در دقیقه (حدود ۹۰۰,۰۰۰ دلار در هر ساعت) رسیده است؛ در حالی که این رقم در گزارشهای پیشین حدود ۹,۰۰۰ دلار در دقیقه برآورد میشد.
این خسارت در موسسات حساس مالی، درمانی و بانکی از مرز ۵ میلیون دلار در ساعت فراتر میرود؛ واقعیتی که نشان میدهد چرا اتخاذ یک راهکار Disaster Recovery دیگر یک اقدام جانبی و اختیاری نیست، بلکه نوعی سرمایهگذاری حیاتی و بیمۀ تجاری برای بقای کسبوکار به شمار میرود.
سه لایۀ کنترلی در استراتژی بازیابی از بحران
یک سازوکار کارآمد برای پاسخ به شرایط اضطراری، بر پایۀ سه لایۀ کنترلی مکمل پیادهسازی میشود:
- کنترلهای پیشگیرانه (Preventive Controls): عبارتاند از اقداماتی که احتمال بروز فاجعه را کاهش میدهند؛ از جمله نگهداری مناسب دیتاسنتر و پیادهسازی شبکه Redundancy برای جلوگیری از قطع مسیرهای ارتباطی.
- کنترلهای تشخیصی (Detective Controls): مانند ابزارهایی که اختلالات را بیدرنگ کشف میکنند؛ نظیر رصد پیوستۀ سلامت تجهیزات با ابزارهای جامع مانیتورینگ.
- کنترلهای اصلاحی (Corrective Controls): سناریوهای بازگردانی دادهها و سوییچ به منابع ثانویه پس از تشخیص خرابی برای جلوگیری از توقف طولانی.
شناخت این سه بازوی شفاف میسازد که هدف پنهان در پس مفهوم Disaster Recovery چیست.
متریکهای Disaster Recovery چیست؟
اثربخشی یک راهبرد احیای زمانی قابل اتکاست که بتوان عملکرد آن را با سنجههای مشخص زمانی و دادهای ارزیابی کرد. متریکهای Disaster Recovery به 3 دستۀ زیر تقسیم میشوند:
- شاخص زمان مجاز بازیابی (RTO): حداکثر بازۀ زمانی قابل تحملی است که طی آن سرویس میتواند خاموش بماند تا تیم فنی آن را مجدداً به چرخه بازگرداند.
- شاخص نقطه مجاز بازیابی (RPO): بیشترین فاصلۀ زمانی مجاز برای از دست رفتن دادههاست؛ یعنی شرکت تا چه میزان حذف دادههای اخیر را بدون لطمه جدی تحمل میکند.
- شاخص یکپارچگی دادهها (RCO): سنجهای برای سنجش سلامت و ثبات ورودیهای داده در دیتابیسهای چندگانه پس از خاتمۀ عملیات بازگردانی است.
سازمانهای بر پایۀ میزان تابآوری، نرمافزارهای خود را طبق جدول زیر رتبهبندی میکنند:
| سطح اهمیت سرویس | توصیف فنی | نیاز RTO / RPO |
| حیاتی | سیستمهای تراکنش مالی، درگاههای پرداخت و پایگاه داده اصلی | کمتر از چند دقیقه (نزدیک به صفر) |
| مهم | سیستمهای انبارداری، نرمافزارهای ارتباط با مشتری (CRM) و ایمیل سازمانی | بین ۱ تا ۴ ساعت |
| غیرضروری | فایلهای آرشیوی، پورتالهای مستندات و دادههای آماری گذشته | بیش از ۲۴ ساعت |
تعیین این خطوط زمانی پایهایترین اقدام برای انتخاب درست در میان انواع Disaster Recovery به شمار میرود.
انواع Disaster Recovery و استراتژیهای پیادهسازی آن
بسته به سطح بودجه، ماهیت دادهها و تعهدات قراردادی، تکنیکهای گوناگونی برای ایجاد زیرساخت نجات وجود دارد که در ادامه به آنها اشاره خواهیم کرد.
۱) مراکز فیزیکی پشتیبان (Disaster Recovery Sites)
ایجاد یک سایت جایگزین در مکانی مجزا، متداولترین مدل کلاسیک است که با 3 رویکرد زیر پیادهسازی میشود:
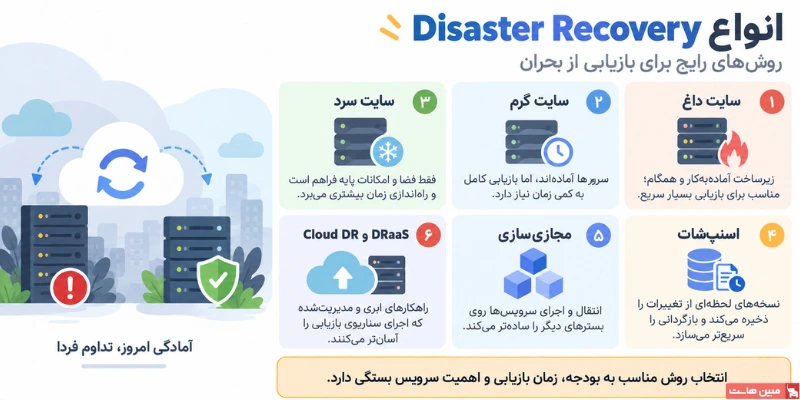
- سایت داغ (Hot Site): زیرساختی کاملاً همگام که آماده است در کسری از ثانیه بار کاری را به دست بگیرد.
- سایت گرم (Warm Site): سرورها در آن نصب هستند، اما دیتابیس لحظهای همگام نمیشود و احیا چند ساعت زمان میبرد.
- سایت سرد (Cold Site): صرفاً دارای فضا، برق و اینترنت است و سختافزارها هنگام واقعه باید نصب و پیکربندی شوند.
استقرار این تجهیزات در یک دیتاسنتر استاندارد، ضامن حفظ ایمنی فیزیکی، تأمین مداوم برق و دسترسی پرسرعت به خطوط اینترنت است.
۲) بهرهگیری از فناوری اسنپشات
ثبت تصویر لحظهای از دیسکها یکی از سریعترین متدهای کاهش زمان بازیابی است. با تکیه بر قابلیت اسنپ شات، سیستم فقط دادههای تغییریافته نسبت به زمان گذشته را ثبت میکند که سبب ذخیرۀ حجم هارد و شتاببخشی به احیای دیتابیس میشود.
۳) بازیابی مجازی و ایزولهسازی منابع
مستقلسازی نرمافزار از سختافزار مسیر بازیابی را هموار میسازد. به کارگیری فناوریهای مدرن مجازیسازی به مدیران شبکه اجازه میدهد تا تمام سیستمعامل و سرویسها را در قالب فایلهای مجزا کپی کرده و روی هر بستر سختافزاری دیگر اجرا کنند. علاوه بر این، استفاده از یک سرور اختصاصی در یک سایت دوردست، تضمین میکند که منابع رم، پردازنده و دیسک بدون دخالت مشترکین دیگر کاملاً در اختیار فرایند بازیابی اضطراری شما باشد.
۴) بازیابی ابری (Cloud DR) و سرویس DRaaS
امروزه راهکارهای ابری نیاز به خرید تجهیزات فیزیکی دوبل را برطرف کردهاند:
- بازیابی ابری (Cloud DR): ذخیرۀ ماشینها و دادهها در سرورهای ابری امن و مقیاسپذیر بدون هزینۀ خرید رک فیزیکی.
- سرویس مدیریتشده (DRaaS): برونسپاری کامل سناریو، زیرساخت، تست و پیادهسازی بازیابی به ارائهدهندۀ تخصصی ابری در ازای حق اشتراک ماهیانه.
۷ مرحلۀ عملیاتی برای تدوین برنامۀ بازیابی از فاجعه
برای سازمانهایی که میخواهند بدانند گامهای اجرایی در پیادهسازی استاندارد Disaster Recovery چیست، اجرای این ۷ مرحلۀ اساسی نقشۀ راهی دقیق و قابل استناد فراهم میآورد:
گام اول: تحلیل اثرات کسبوکار (BIA)
نخستین و پایهایترین مرحله در ساخت برنامۀ بازیابی، اجرای تحلیل اثرات کسبوکار (Business Impact Analysis) است. در این فرایند، سناریوهای فاجعهبار شبیهسازی میشوند تا مشخص شود خرابی هر بخش، چه ابعادی از زیان مالی و عملیاتی را برای شرکت رقم میزند.
- پیامدهای توقف فروش آنلاین به ازای هر ساعت قطعی محاسبه میشود.
- سقف زمانی قابل تحمل برای توقف هر فرایند تجاری استخراج میشود.
- سناریوهای جایگزین برای ادامۀ فعالیت کارکنان در مواقع اضطراری طرحریزی میشود.
گام دوم: ارزیابی و تحلیل ریسک
پس از شناسایی نقاط حساس کسبوکار، نوبت به ارزیابی دقیق خطراتی میرسد که ممکن است زیرساخت را تهدید کنند. این گام بر اساس شرایط جغرافیایی و حوزۀ تخصصی فعالیت شرکت تنظیم میشود.
- احتمال وقوع بلایای طبیعی مانند سیل یا زلزله در محل دیتاسنتر اصلی بررسی میشود.
- میزان مقاومت ساختار فعلی در برابر باجافزارها و نفوذگران سایبری سنجیده میشود.
- ریسک ناشی از خطای کارکنان، نوسانات برق منطقهای و خرابی سختافزار تحلیل میگردد.
گام سوم: اولویتبندی برنامهها و سرویسها
تمامی سرویسها و نرمافزارهای یک سازمان ارزش یکسانی ندارند و احیای همزمان همۀ آنها در یک بحران، منابع فنی را فرسوده میکند؛ بنابراین، طبقهبندی دقیق آنها الزامی است.
- سرویسهای حیاتی بقای کسبوکار (مانند درگاه پرداخت و دیتابیس مشتریان) در اولویت نخست قرار میگیرند.
- سامانههای مهم اداری (مانند نرمافزار منابع انسانی یا ایمیل شرکتی) در لایۀ بعدی احیا جای میگیرند.
- نرمافزارهای فرعی که وقفۀ چند روزۀ آنها صدمهای به تجارت نمیزند، در اولویت آخر قرار میگیرند.
گام چهارم: مستندسازی و کشف وابستگیهای سامانهها
در معماریهای پیچیده امروزی، سرویسها مانند زنجیرهای بههمپیوسته کار میکنند و روشن کردن یک نرمافزار، منوط به فعال بودن پیشنیازهای متعددی است که موارد زیر تعدادی از این مستندسازیها را برایتان مشخص میکند.
- فهرست کاملی از تمامی قطعات سختافزاری و ماژولهای نرمافزاری استخراج میشود.
- وابستگی پایگاههای داده به سرویسهای احراز هویت و کش به شکل مدون ثبت میگردد.
- ترتیب دقیق روشن شدن سرویسها تعیین میشود تا فرایند احیا به دلیل فقدان یک پیشنیاز قفل نشود.
گام پنجم: تعیین اهداف زمانی و دادهای
بر مبنای تحلیلهای مراحل قبل، تیم فنی برای هر اپلیکیشن مقادیر شفاف و عددیای مشخص میکند تا چارچوب فنی انتخاب فناوریها مشخص شود. یعنی:
- زمان دقیق مجاز برای در دسترس قرار گرفتن هر سرویس (RTO) مستند میگردد.
- حجم مجاز دادههایی که ممکن است بر اثر حادثه از دست بروند (RPO) تعریف میشود.
- هماهنگی و یکپارچگی دادهها بین پایگاههای گوناگون (RCO) به عنوان هدف کیفی تنظیم میشود.
گام ششم: تطابق با الزامات قانونی و امنیتی
دادههای پشتیبان و سایتهای بحران نباید ضعیفتر از سایت اصلی باشند؛ زیرا نشت دادهها در زمان بحران میتواند جریمههای حقوقی هنگفتی را به بار آورد. برای این منظور بهتر است:
- مکان نگهداری دادههای پشتیبان با قوانین محلی و استانداردهای حریم خصوصی تطبیق داده شود.
- استانداردهای حفاظت از دادهها و رمزنگاری در تمامی مسیرهای انتقال و ذخیرهسازی اعمال شود.
- دسترسیهای کارشناسان به محیط بازیابی به شکلی محدود شود تا اصول امنیتی نقض نشود.
گام هفتم: آزمون مستمر و بهروزرسانی مداوم
برنامهای که آزمایش نشده باشد، در روز فاجعه کار نخواهد کرد. یک برنامه پویای بازیابی بحران باید به صورت دورهای در سناریوهای واقعی سنجیده شود. برای نمونه باید:
- مانورهای شبیهسازی قطعی و سوییچ به دیتاسنتر دوم با حضور همه مهندسان مسئول انجام یگیرد.
- نقایص کشفشده در مانورها مستند شده و سناریوی بازگردانی اصلاح شوند.
- با هر تغییر در معماری شبکه یا ارتقای سرورها، مستندات برنامۀ بازیابی بهروزرسانی شود.
نقش هوش مصنوعی و روندهای نوین در بازیابی بحران
فناوریهای مدرن نحوۀ مدیریت فجایع زیرساختی را دگرگون ساختهاند. ادغام هوش مصنوعی (AI) و یادگیری ماشین (ML) با ابزارهای پشتیبانگیری، این امکان را فراهم کرده است تا سیستمها پیش از خاموشی کامل سختافزار، ناهنجاریها و خرابی دیسکها را پیشبینی کنند.
بر اساس دادههای ارائهشده در گزارش معتبر شرکت IBM در سال ۲۰۲۵ پیرامون هزینههای نشت داده (Cost of a Data Breach Report)، بهرهگیری از اتوماسیون هوش مصنوعی توانسته میانگین زمان شناسایی و مهار بحرانها را به ۲۴۱ روز کاهش دهد که سریعترین میزان در ۹ سال گذشته است. افزون بر این، پیادهسازی معماری امنیت صفر (Zero Trust) و راهکارهای تابآوری سایبری باعث شده تا مخازن بازیابی از دسترس بدافزارها دور بمانند و احیای سرویسها با ضریب اطمینان کامل انجام پذیرد.
چالش پیادهسازی Cloud DR برای کسبوکارهای ایرانی
استفاده از راهکارهای بینالمللی مانند AWS ،Google Cloud یا Microsoft Azure به دلایل زیر برای کسبوکارهای ایرانی با موانع جدی روبهرو است:
- مسدودسازی دسترسی، تحریمها و ریسک مسدود شدن ناگهانی اکانتها.
- نوسانات شدید نرخ ارز و هزینههای دلاری غیرقابل پیشبینی.
- اختلالات مسیرهای بینالمللی اینترنت و تأخیر شبکه حین بازیابی دادهها.
برای عبور از این بنبست، پیادهسازی معماری هیبریدی پایدارترین انتخاب است. در این الگو، بار پردازشی پروداکشن روی سرورهای داخلی میزبانی میشود و برای مصون ماندن از ریسکهای فیزیکی، تحریمی یا نوسانات شبکه، یک نسخۀ آمادهبهکار روی سرورهای خارج از کشور مستقر میشود. برای این منظور استفاده از سرور مجازی (VPS) خارج مبین هاست این امکان را به شما میدهد که با مدیریت هزینهها بهصورت ریالی و بهرهمندی از پورتهای ارتباطی پرسرعت بینالمللی، یک سایت بازیابی ایزوله با کمترین تأخیر در Replicate دادهها در اختیار داشته باشید تا در روز واقعه، سرویس شما در کسری از زمان دوباره آنلاین شود.
اگر برای تدوین سناریوی Failover، انتخاب لوکیشن مناسب و راهاندازی زیرساخت Disaster Recovery به یک استراتژی اختصاصی نیاز دارید، همین حالا با کارشناسان فنی مبین هاست تماس بگیرید تا زیرساخت شما را برای بالاترین سطح تابآوری تجهیز کنیم.
کلام آخر
دانستن اینکه هدف و بازدهی واقعی Disaster Recovery چیست، مرز میان پایداری یک کسبوکار دیجیتال و خروج همیشگی آن از بازار رقابت را تعیین میکند. آسیبهای ناشی از حوادث طبیعی، نقص قطعات، خطاهای ناخواسته و رخنههای سایبری همواره در کمین زیرساختها هستند؛ بنابراین، برنامهریزی دقیق، تدوین سنجههای واقعبینانه RTO و RPO، استفاده از فناوریهای ابری و اجرای آزمونهای منظم، سپری مستحکم میسازد تا سرمایههای دادهای شما در هر سناریویی ایمن و دسترسپذیر باقی بمانند.
منابع
سوالات متداول
خیر. فایل بکاپ تنها دادۀ خام ذخیرهشده است و در زمان سوختن سختافزار یا قطع کابلها، نیاز به سرور و شبکۀ مجزایی برای فعالسازی آن دارید که این فرایند توسط دیزستر ریکاوری مدیریت میشود.
این سرویس برای کسبوکارهای متوسط یا شرکتهایی که تمایلی به سرمایهگذاری سنگین جهت اجارۀ سالن دوم دیتاسنتر و خرید سختافزار مازاد ندارند، گزینهای بسیار منعطف و اقتصادی است.
فاصله باید به میزانی باشد که حوادث منطقهای همزمان نظیر سیل، زلزله، اختلال سراسری شبکه برق یا شرایط نامساعد جوی نتواند هر دو مرکز داده را از کار بیندازد.